
#P15640. [ICPC 2022 Tehran R] Simplification

[ICPC 2022 Tehran R] Simplification
题目描述
Amin 会时不时地记录他的股票价格,作为一个数据点 记在笔记本上,其中 是股票在第 天的价格。这些数据点构成的序列代表了一个分段线性函数 ,展示了一段时间内的价格历史。实际上, 通过直线段连接每一对连续的点。如果某一天 没有记录价格,则可以用 作为估计值。
由于他长期跟踪股票价格,收集的数据变得越来越大。因此,他决定通过丢弃一些已记录的数据点来缩减数据,并用剩余的点构造一个新的分段线性函数 。 被称为 的一个 “简化”。Amin 希望以这样一种方式创建简化,使得 是 的一个良好近似。为此,他定义了一个误差度量如下。
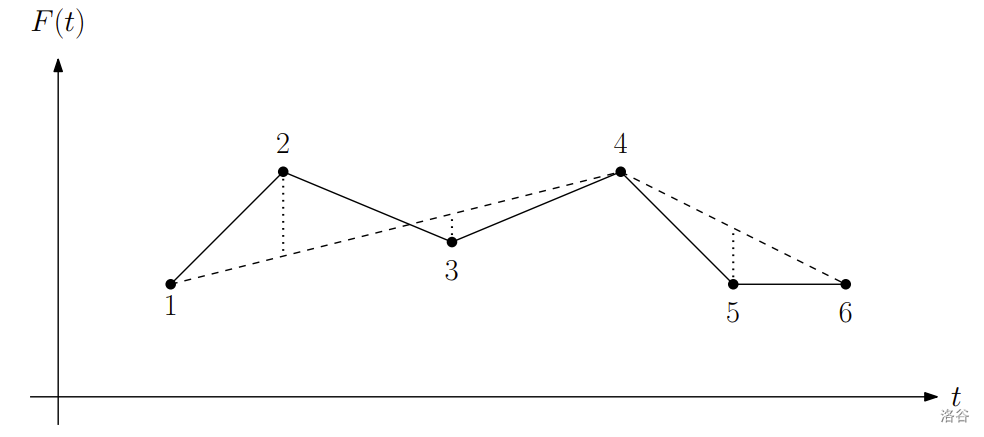
设 定义在一个严格递增的天数序列 上,而 定义在 的一个子序列 上,其中 ,,并且对于 有 。(我们称 为 的大小。) 的误差定义为所有 中 的最大值。例如,在下图中,我们有 个数据点,标记为 到 ,其坐标与第二个样例输入中给出的相同,而 是一个大小为 的简化,包含数据点 、 和 。在此图中, 用实线描绘, 用虚线描绘。 的误差度量由点 到 的垂直距离体现。
:::align{center}
 :::
Amin 的目标是在 的误差不超过给定值 的前提下,最小化 的大小。
输入格式
输入的第一行包含一个正整数 (),表示 的大小。接下来的 行,每行包含两个整数 , (),其中 是股票在第 天的价格。最后一行包含误差限制 ,它是一个不超过 的非负整数。
输出格式
在输出中,打印 的最小可能大小。
3
1 10
3 100
10 20
90
2
6
10 10
20 20
35 14
50 20
60 10
70 10
8
3
提示
翻译由 DeepSeek V3.2 完成